بایگانی دسته: آموزش Spss اس پی اس اس

فیلم رایگان آشنایی با نوارها در   spss

spss-p-1-  فیلم رایگان آشنایی با نوارها در   spss

در این فیلم انواع نوارها و نحوه ی تغییر آن ها تشریح شده است.

سفارش تحلیل داده های آماری برای پایان نامه و مقاله و ...

ما قصد داریم تحلیل داده های شما را با کم ترین هزینه و بالاترین کیفیت انجام بدهیم. قیمت تحلیل ها بسیار پایین می باشد و پایین تر از هر جای دیگر است و بسته به نوع و میزان کار بین 500 تا 600 هزار تومان خواهد بود. فعلاً تحلیل داده های آماری با نرم افزارهای SPSS- PLS - Amos و نرم افزارهای کیفی Maxquda و انویو Nvivoانجام می گیرد. جهت سفارش تحلیل فرم زیر را تکمیل نمایید.
  • لطفا ایمیل خود را دقیق بنویسید
  • شماره همراه خود را دقیق بنویسید.
  • لطفاً فرضیه هایا سوال های پژوهشی خود را در قالب ورد یا pdf در اینجا آپلود نمایید.
    Accepted file types: doc, docx, pdf.
  • This field is for validation purposes and should be left unchanged.

توزیع فـراوانی ­ها در SPSS (    فراوانی و درصد فراوانی و درصد فراوانی معتبر و درصد تجمعی)

توزیع فـراوانی ­ها در SPSS (    فراوانی و درصد فراوانی و درصد فراوانی معتبر و درصد تجمعی)

اولین­ کاری که بعد از گردآوری و وارد کردن داده­ ها انجام شود  شمارش تعداد افرادی است که پاسخ ­های معیّنی به هر پرسش داده­ اند. با این کار نحوه ­پراکندگی یا توزیع­ نمونه را در طبقات ­­مختلف هر­متغیر بررسی می­ کنیم. نتیجه این شمارش توزیع فراوانی است. توزیع فراوانی به طور متداول شامل فراوانی و درصد فراوانی است که عموما برای متغیرهای اسمی یا ترتیبی به­ کار می رود. کاربرد آن برای متغیرهای فاصله ­ای/­نسبی فقط زمانی که تعداد طبقات متغیر کم باشد و یا متغیر کمّی را به متغیری ترتیبی تبدیل کنیم، مناسب است. مثلا در مورد تعداد اعضاء خانواده (بعد خانوار)، استفاده از آماره فراوانی فقط زمانی مناسب که است تعداد اعضا شامل حدود 6 طبقه باشد. همچنین زمانی که درآمد افراد را به صورت عددی می­ سنجیم ولی درآمد افراد را کدگذاری مجدد کرده و در پنج طبقه قرار بدهیم می­ توانیم از توزیع فراوانی برای متغیر درآمد بهره بگیریم. در مجموع می­ توان گفت که در وضعیتی که طبقات تشکیل ­دهنده یک متغیر فاصله ­ای/نسبی محدود باشد (کمتر از 10 طبقه باشد)، استفاده از آماره فراوانی مناسب است.

ادامه‌ی خواندن→

عملیات ریاضی ، شاخص ها و آزمون های آماری به تفکیک هر یک از مقیاس های اندازه گیری
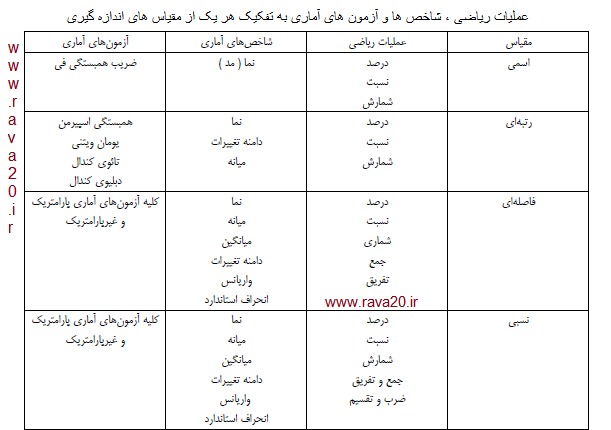
عملیات ریاضی ، شاخص ها و آزمون های آماری به تفکیک هر یک از مقیاس های اندازه گیری

سفارش تحلیل داده های آماری برای پایان نامه و مقاله و ...

ما قصد داریم تحلیل داده های شما را با کم ترین هزینه و بالاترین کیفیت انجام بدهیم. قیمت تحلیل ها بسیار پایین می باشد و پایین تر از هر جای دیگر است و بسته به نوع و میزان کار بین 500 تا 600 هزار تومان خواهد بود. فعلاً تحلیل داده های آماری با نرم افزارهای SPSS- PLS - Amos و نرم افزارهای کیفی Maxquda و انویو Nvivoانجام می گیرد. جهت سفارش تحلیل فرم زیر را تکمیل نمایید.
  • لطفا ایمیل خود را دقیق بنویسید
  • شماره همراه خود را دقیق بنویسید.
  • لطفاً فرضیه هایا سوال های پژوهشی خود را در قالب ورد یا pdf در اینجا آپلود نمایید.
    Accepted file types: doc, docx, pdf.
  • This field is for validation purposes and should be left unchanged.

تفاوت تحليل عاملي تاييدي و اكتشافي چیست؟

تفاوت تحليل عاملي تاييدي و اكتشافي چیست؟

تحلیل عاملی

از روش تحليل عاملي يا Factor Analysis جهت پي بردن به متغيرهاي زير بنايي يك پديده يا تلخيص مجموعه اي از داده‌ها استفاده مي‌شود.

در تحلیل عاملی به دنبال جوابگویی به 4 سوال زیر هستیم:

  • آیا مجموعه ای از آیتم ها (معرف ها)به تعداد کم تری از عوامل (حداقل یک عامل ) قابل تقلیل هستند .

  • اگر جواب سوال 1 بلی است معرف ها به چند عامل قابل تقلیل هستند؟ آیا یک مفهوم نظری کافی است؟ انتظار داریم حداقل یک عامل را از آن ها استخراج کرد.

  • هر معرف به کدام عامل ربط دارد؟ (گروهبندی آیتم ها) یعنی هر معرف بر روی کدام عامل بارگذاری می شود؟ مثلاً کدام آیتم ها به عامل 1 کدام به عامل 2 و … ربط دارد؟

  • چه نامی می توان بر روی عامل های استخراج شده گذاشت؟ (جواب گویی به این سوال بیشتر بر اساس خلاقیت محقق و دانش نظری وی انجام می گیرد؟)


 داده‌هاي اوليه براي تحليل عاملي، ماتريس همبستگي بين متغيرها است. تحليل عاملي، متغيرهاي وابسته از قبل تعيين شده اي ندارد. موارد استفاده تحليل عاملي را به دو دسته كلي مي‌توان تقسيم كرد: مقاصد اكتشافي و مقاصد تاييدي. اگر شما هیچ حدسی از ساختار روابط میان گویه ها نداشته باشید از تحلیل عاملی اکتشافی استفاده می شود. اما اگر گویه ها را براساس ابعاد شناسائی کرده باشید باید از تحلیل عاملی تائیدی استفاده کنید.


– تحليل عاملي اکتشافي (EFA)

در تحليل اکتشافي يا Exploratory factor analysis پژوهشگر به دنبال بررسي داده‌هاي تجربي به منظور کشف و شناسايي شاخصها و نيز روابط بين آنهاست. در اينجا از پيش مدل معيني وجود ندارد. به بيان ديگر تحليل اکتشافي علاوه بر آنکه ارزش تجسسي يا پيشنهادي دارد مي‌تواند ساختارساز، مدل ساز يا فرضيه ساز باشد. تحليل اکتشافي وقتي به کار مي‌رود که پژوهشگر شواهد کافي قبلي و پيش تجربي براي تشکيل فرضيه درباره تعداد عاملهاي زيربنايي داده‌ها نداشته و به واقع مايل باشد درباره تعيين تعداد يا ماهيت عامل‌هايي که همپراشي بين متغيرها را توجيه مي‌کنند داده‌ها را بکاود. بنابراين تحليل اکتشافي بيشتر به عنوان يک روش تدوين و توليد تئوري و نه يک روش آزمون تئوري در نظر گرفته مي‌شود.

تحليل عاملي تائيدي (CFA)

در تحليل عاملي تاييدي ياConfirmatory factor analysis پژوهشگر به دنبال تهيه مدلي است که فرض مي‌شود داده‌هاي تجربي را بر پايه چند پارامتر نسبتاً اندک، توصيف تبيين يا توجيه مي‌کند. اين مدل مبتني بر اطلاعات پيش تجربي درباره ساختار داده‌ها است که مي‌تواند به شکل يک تئوري يا فرضيه، يک طرح طبقه بندي کننده معين براي گويه‌ها در انطباق با ويژگيهاي عيني شکل و محتوا،شرايط معلوم تجربي و يا دانش حاصل از مطالعات قبلي درباره دادههاي وسيع باشد. روشهاي تاييدي (آزمون فرضيه) تعيين مي‌کنند که داده‌ها با يک ساختار عاملي معين (که در فرضيه آمده) هماهنگ هستند يا نه.

به طور خلاصه اگر به 4 سوال بالا بر مبنای نظری پاسخ بدهیم تحلیل عاملی تأییدی است چون قبل از جمع آوری داده ها می توان به سوال های تحلیل عاملی بر مبنای نظریه جواب داد. اما در تحلیل عاملی اکتشافی پاسخ به سوالات تحلیل عاملی بر مبنای داده هاست. در اینجا یا نظریه نداریم یا اینکه موقتاً آن را کنار می گذاریم تا بر مبنای داده ها به نظریه برسیم.

تحلیل عاملی اکتشافی با نرم افزار آماری Spss و تحلیل عاملی تأییدی با PLS  و Amos  انجام می گیرد.

برای انجام این تحلیل ها توسط ما اینجا کلیک نمایید.


استفاده از مطالب این سایت با ذکر منبع ( WWW.rava20.ir) بلامانع است.

انتخاب صحیح آزمون آماری

انتخاب صحیح آزمون آماری

یکی از مشکلات عمومی در تحقبقات میدانی انتخاب صحیح آزمون آماری برای بررسی سوالات یا فرضیات تحقیق می‌باشد. در آزمون‌های آماری هدف این است که ببینیم آیا داده‌های نمونه شواهد کافی برای رد یک حدس یا فرضیه را دارند یا خیر؟ انتخاب نادرست آزمون آماری موجب خدشه دار شدن نتایج تحقیق می شود.

ادامه‌ی خواندن→

واریانس و کوواریانس چیست؟

واریانس و کوواریانس چیست؟

واریانس:

واریانس را «مقدار متوسط مربع اختلاف مقادیر از میانگین» تعریف می‌کنند. برای محاسبه واریانس باید ابتدا میانگین ساده اعداد را پیدا کنید. در ادامه برای هر عدد باید مقدار میانگین را از آن کم کرده و نتیجه بدست آمده را به توان دو برسانید و در واقع مربع اختلاف را بدست آورید. سپس باید میانگین مربع اختلافاتی که بدست آورده‌اید را محاسبه نمایید تا واریانس بدست آید. 

کوواریانس :


کوواریانس شاخصی برای تغییرات یک متغیر با متغیر دیگر است (سرمد،۱۳۸۸: ۸۰). کوواریانس مشابه واریانس است ولی در کوواریانس انحراف از میانگین را به طور همزمان برای دو متغیر  x و y محاسبه می کنیم .

چنانکه دو متغیر تصادفی ناوابسته باشند، کواریانس آنها صفر خواهد بود(سرمد،۱۳۸۸: ۱۲). اگر نمره بالا در یک متغیر با نمره بالا در متغیر دیگر و نمره پایین در یک متغیر با نمره پایین در متغیر دیگر همراه باشد، مقدار کوواریانس مثبت (هم جهت بودن تغیرات دو متغیر) خواهد بود. از طرف دیگر اگر نمره بالا در یک متغیر با نمره پایین در متغیر دیگر همراه باشد، مقدار کوواریانس منفی (غیر هم‏جهت بودن تغیرات دو متغیر) خواهد بود (کیامنش،۱۳۸۷: ۱۹۸) . لازم به ذکر است که در توزیع‏های دومتغیری برای توصیف رابطه میان دو متغیر از ضریب همبستگی، کوواریانس و معادله رگرسیون استفاده می‏کنیم.


تجزیه و تحلیل داده های آماری با SPSS، Amos, Maxqda

 [huge_it_slider id=”2″]

تجزیه و تحلیل داده های آماری
با توجه به گستردگی آزمون ها و ابزارهای آماری عملاً امکان و فرصت تجزیه و تحلیل داده ها برای دانشجویان و محققان وجود ندارد، ما سعی کرده ایم با تجربه بیش از یک دهه این مشکل را با هزینه ای بسیار کم حل نماییم. برای این منظور محققان جهت تجزیه و تحلیل داده های خود با استفاده از نرم افزارهای آماری SpSS و Amos  و همچنین نرم افزار تحلیل کیفی MAXQDA (جهت تحلیل ، متن، عکس و فیلم) به یکی از روشهای زیر با ما در تماس باشند. 

تماس با ما:

Email 1 :    Abazizi1392@Gmail.com
email2:      abazizi@rava20.ir

همراه: 09102194672

تلگرام:

@abazizi

هزینه انجام تحلیل ها بسیار پایین و بسته به نوع تحقیق، تعداد داده و تعداد فرضیه معمولاً برای  دانشجویان کارشناسی ۲۰۰ تا ۲۵۰ هزار تومان و برای دانشجویان کارشناسی ارشد و دکتری  ۲۵۰ تا ۳۰۰هزار تومان می باشد. همچنین برای افرادی که بیش از دو تحلیل سفارش بدهند مبلغ ۱۰ %  و برای افرادی که بیش از ۵ تحلیل سفارش بدهند ۲۰% تخفیف داده خواهد شد.

تحلیل ها با بالاترین کیفیت ، در اسرع وقت و در قالب نرم افزار Word  تحویل داده خواهد شد.

تحلیل خوشه ای (خوشه بندی) (Cluster Analysis)

تحلیل خوشه ای (خوشه بندی) (Cluster Analysis)

تجزیه و تحلیل خوشه ای، یک روش آماری برای گروه بندی داده ها یا مشاهدات، با توجه به شباهت یا درجه نزدیکی آنها است. از طریق تجزیه و تحلیل خوشه ای داده ها یا مشاهدات به دسته های همگن و متمایز از هم تقسیم می شوند. از این روش برای بخش بندی کردن مشتریان بر مبنای شباهت هایشان استفاده می شود. غالبا در تحلیل خوشه ای، تصمیم گیری درباره تعداد خوشه ها بر مبنای ملاک بیزی و ملاک آکائیکه گرفته می شود. جوابی در سطح حد اقل ملاک بیزی و ملاک آکائیکه به دست می آید، می تواند معرف بهترین تعادل موجود بین دقت و پیچیدگی باشد که مهم ترین تاثیرات را در نظر بگیرد و اهمیت آنها را کم نشان ندهد. همچنین، راه دیگر برای تصمیم گیری در زمینه تعداد خوشه ها، استفاده از نسبت فاصله می باشد. بهینه ترین تعداد خوشه ها هنگامی است که تغییری بزرگ در نسبت فاصله مشاهده می گردد.

اصطلاح تحلیل خوشه ای اولین بار توسط Tryon در سال ۱۹۳۹ برای روش های گروه بتدی اشیائی که شبیه بودند مورد استفاده قرار گرفت. تجزیه خوشه ای ابزار میانبر تحلیل داده هاست که هدف آن نظم دادن به اشیا مختلف به گروه هایی که درجه ارتباط بین دو شئی اگر آنها به یک گروه تعلق داشته باشند حداکثر و در غیر این صورت حداقل است. به عبارت دیگر تحلیل خوشه ای ساختار داده ها را بدون توضیح اینکه چه وجود دارد را نشان می دهد.

تحلیل خوشه ای یک ابزار اکتشاف  است و نتایج آن ممکن است ۱)در تعریف یک طرح طبقه بندی مانند رده بندی حیوانات، حشرات یا گیاهان مفید باشد. ۲)قواعدی برای اختصاص موارد جدید به طبقه ها به منظور شناسایی و تشخیص به دست دهد. ۳)حدود تعریف، اندازه و تنوغ و تعریف برای آنچه قبلا به شکل مفاهیم وسیعی بوده است، فراهم آورد. ۴) نمونه هایی برای معرفی طبقه ها بیاید. ۵)مدل آماری برای توصیف جامعه ارائه دهد.

مفاهیم فاصله و تشابه از مفاهیم اساسی تحلیل خوشه ای است. فاصله اندازه‌ای است که نشان می دهد دو مشاهده تا چه حد جدا از یکدیگرند. در حالی که تشابه شاخص نزدیکی آنها با یکدیگر است. پژوهشگر قبل از تحلیل، نخست باید یک مقیاس کمی  را که بر پایه همخوانی(تشابه) بین مشاهده‌ها اندازه گرفته می شود را انتخاب کند. این شاخص ها با توجه به الگوریتم تشکیل خوشه، ماهیت متغیر ها(پیوسته، گسسته یا دو ارزشی) و مقیاس اندازه گیری انتخاب می شوند.

مثال های از تحلیل خوشه ای:

  • اگر بخواهیم کشورها را بر حسب شاخص های فرهنگی و اقتصادی طبقه بندی کنیم.
  • اگر بخواهیم کلان شهر ها را بر حسب شاخص های بهداشتی و آموزشی طبقه بندی کنیم.
  • اگر بخواهیم افراد را بر اساس ویژگی های شخصیتی طبقه بندی کنیم.

اولین کار برای تحلیل خوشه ای نشان داده واحد ها (افراد) بر روی یک نمودار پراکندگی است.


اگر داده هایی دhرید و می خواهید آن ها را با نرم افزار Spss تحیلیل کنید می توانید با قیمتی بسیار پاین و کیفیت بالا آن از ما بخواهید.

تجزیه و تحلیل داده ها با نرم افزار Spss