بایگانی دسته: آموزش نرم افزارهای آماری

صفر تا صد نرم افزار لیزرل

صفر تا صد نرم افزار لیزرل

نرم‌ افزار لیزرل یکی از مهم ترین نرم افزارهای تحلیل داده می باشد که بیشتر برای ترسیم مدل معادلات ساختاری و تحلیل عاملی تاییدی و تحلیل مسیر به کار می آید. در این مقاله با آموزش لیزرل همراه  ما باشید تا به روش کاربردی صفر تا صد برنامه لیزرل به صورت کلی بررسی می شود.

نرم افزار لیزرل چیست ؟

نرم‌ افزار LISREL یکی از پر کاربردترین نرم افزار های آماری برای تحلیل عاملی است. این نرم افزار ابتدا توسط کارل یورسکاگ (Karl Jöreskog) و دگ سوربوم (Dag Sörbom) خلق شد. لیزرل Lisrel در واقع به عبارت linear structural relations اشاره دارد که به معنی روابط ساختاری خطی می باشد. زمانی که پژوهشگر قصد دارد روایی یک آزمون را با استفاده از تحلیل عاملی (CFA) بررسی کند این نرم افزار مکمل نرم افزار spss خواهد بود. همین طور با این نرم افزار می توانید به مدل سازی معادلات ساختاری بپردازید که امکان آن در spss موجود نمی باشد.

کاربرد نرم افزار لیزرل

به صورت کلی این نرم افزار برای ترسیم معادلات ساختاری بین متغیرها و بررسی روایی ازمون ها استفاده می شود. این نرم افزار بر اساس روش همبستگی (Correlation) و روش کوواریانس (Covariance) ، بارهای عاملی که بر روی یک متغیر وجود دارد را بررسی می کند و ما می توانیم تشخیص دهیم که ان سوال را از مقیاس حذف کنیم یا نگه داریم. هیمن طور این نرم افزار واریانس و متغیرهای پنهان را برای ما مشخص می کند. در اصل ما با این نرم افزار بر اساس متغیر های قابل مشاهده (Observable) تحقیق به متغیر های پنهان تحقیق دست پیدا می کنیم. به صورت کلی اقداماتی که می توان در این نرم افزار انجام داد شامل این موارد است:

  • بررسی متغیرهای پنهان
  • تحلیل عاملی تاییدی
  • تحلیل مسیر (مدل‌سازی علت و معلولی برای متغیرهای پنهان)
  • تحلیل ساختار کوواریانس (Linear Structural Relations – LSR)
  • معادلات ساختاری SEM

تحلیل عاملی با لیزرل

برای آموزش لیزرل از تحلیل عاملی شروع می کنیم. زمانی که شما قصد دارید یک مقیاس را در پژوهش کنید باید یکبار تحلیل عاملی تاکیدی را بر روی سوالات این مقیاس پیاده سازی نمایید. با استفاده از این نرم افزار می توان هر دو نوع تحلیل عاملی را بررسی کرد یعنی :

  1. Exploratory Factor Analysis
  2. Confirmatory Factor Analysis

مثال برای تحلیل عاملی تاکیدی (Factor Analysis)

مثلا ما یک مقیاسی را در زمینه سنجش رفتار شهروندی سازمانی طراحی کرده ایم و قصد داریم بررسی کنیم که سوالات این مقیاس چند عامل را می سنجند؟

factor analysis چیست ؟

در نظر بگیرید برای سنجش یک سازه 30 سوال را طراحی کرده ایم . در علم آمار مشخص شده است که این سوالات ممکن است سازه های دیگری را بسنجند و در اصل ما متغیر های پنهان داریم . متغیر های پنهان متغیر هایی هستند که ما در مورد آن ها اطلاعاتی نداریم ولی داریم آن ها را می سنجیم . زمانی که ساختار زیربنایی سوالات را بررسی می کنیم و از آن ها کوواریانس می گیریم مشخص می شود که هر سوالی به یک سری دیگر از سوالات ارتباط دارد و حول بک متغیر مشخص و یکسان هستند . بر حسب صفات مشترک در این سوالات یا گویه ها محقق می تواند کل سوالات را به دو يا چند دسته تقسیم کند. در آمار به اين دسته ها ، عامل گفته می شود. هر عامل یک متغیر پنهان است که از تركيب چند سوال (آن ها را هم متغیر محسوب می کنیم) که با هم رابطه بالایی دارند، ساخته می شود.  تحليل عاملي یک روش آماری است که به كشف این عامل ها در یک مقیاس می پردازد و مشخص می کند ما چند عامل داریم و کدام سوالات مربوط به کدام عامل ها است ؟

تحلیل عاملی اکتشافی

در نظر بگیرید که شما یک پرسشنامه جدید را ایجاد کرده اید . سوالی که پیش می اید این است که این گویه ها و یا سوالات مقیاس جدید شما (پرسشنامه محقق ساخته) چند عامل را بررسی می کند؟ در چنین موردی از تحلیل عاملی اکتشافی استفاده می شود . تحلیل عاملی اکتشافی (EFA ) یکی از روش های تحلیل عاملی است که در آن هدف ما بررسی این موضوع می باشد که در سئوالات مقیاس ما و به طور کلی آنچه داریم می سنجیم ، چند عامل پنهان وجود دارد؟ در واقع ما می خواهیم یک مدل برای سئوالات یا متغیر های تحقیق خود ترسیم نماییم و بار عاملی هر متغیر را بررسی کنیم (در مدلی که ترسیم می کنیم) . تحلیل عاملی اکتشافی زمانی استفاده می شود که از پیش برای روابط بین متغیرهای مقیاس ما مدلی ترسیم نشده باشد و پیش‌ فرضی وجود ندارد که چند عامل پنهان وجود دارد . هدف بررسی تحلیل عاملی این است که عامل‌هایی را پیدا کنیم که بیشترین پراکندگی متغیرها را در اطراف خود دارد و به اصطلاح بار عاملی زیر متغیرهای آن بالا باشد. روش اکتشافی بر این مبنا کار می کند که واریانس مشترک بین متغیر های تحقیق (یک مقیاس) را شناسایی می کند . روش کشف عامل ها از طریق ترسیم ماتريس همبستگي بين متغيرها بدست می باشد.

آموزش تحلیل عاملی تاییدی در نرم افزار لیزرل

تحلیل عاملی تاییدی (CFA) به بررسی مدلی که در گام قبلی توسط تحلیل عاملی اکتشافی ارایه شده می پردازد و محقق قصد دارد ، این تحلیل و مدل بدست آمده را تایید یا رد کند. عموما زمانی که شما می خواهید از مقیاس های از پیش ساخته استفاده کنید برای بررسی روایی مقیاس از تحلیل عاملی تاییدی استفاده می شود . این روش متغیر هایی را که در مدل بدست آمده موثر است را شناسایی می کند و متغیرهای فرعی را حذف می‌کند. برای اجرای تحلیل عامل تایید در لیزرل باید پس از وارد کردن داده های تحقیق در نرم افزار گزینه Path Diagram را انتخاب نمایید.

تحلیل عاملی تاییدی

بعد از مشخص کردن مکان پروژه باید متغیرهای نهان و آشکار خود را تعریف کنید. برای این کار باید ابتدا بر روی گزینه Add/Read/variable در زیر بخش Observed variables بزنید، تا متغیرهای آشکار را تعریف کنید.

تحلیل عاملی تاییدی

در کادر باز شده باید روی گزینه مشخص شده (گزینه دوم) کلیک نمایید. گزینه اول لیست سیستمی فایل لیزرل است که برای داده های کوواریانسی به کار می رود و گزینه دوم برای داده های خام می باشد. سپس بر روی browse کلیک کنید و فایل داده ها را فراخوانی کنید.

تحلیل عاملی تاییدی

در مرحله بعدی باید به تعریف سازه ها یا متغیرهای پنهان یا همان عامل های تحقیق بپردازید. برای این کار باید از بخش Latent variables گزینه را Add/Read/variable را بزنید.

تحلیل عاملی تاییدی

در پایان تعداد نمونه ها را مشخص نمایید و بر روی گزینه ok بزنید.

تحلیل عاملی تاییدی
تحلیل عاملی تاییدی

شما اکنون می توانید مدل خود را ترسیم کنید و با فلش متغیرها را به هم وصل نمایید.

تحلیل عاملی تاییدی

آموزش مدل معادلات ساختاری در نرم افزار لیزرل

یکی از مبانی بررسی داده ها در نرم افزار لیزرل ، تجزیه و تحلیل ساختارهای کوواریانس بین سئوالات است که به آن مدل یابی معادلات ساختاری (Structural equation modeling) هم می گویند . هدف پیش‌ بینی و تشخیص روابط بین متغیر های مستقل و وابسته می باشد . این روش به همراه همبستگی بین متغیر ها چهار کاربرد اصل دارد :

  1. این روش برای پیدا کردن روابط علت و معلولی بین متغیرها استفاده می شود (در اصل می توان با این روش تاثیرات همزمان متغیرهای مستقل روی یک متغیر وابسته را بررسی نمود )
  2. همین طور جایگاه هر یک از متغیر های میانجی (کنترلی، مداخله گر و تعدیل کننده) را تشخیص داد
  3. متغیرهای پنهان (Latent Variable) در تحلیل و آزمون های ما که در اصل در روش تحقیق به آن ها سازه هم گفته می شود را می توان مشخص کرد (مثلا عزت نفس یک سازه است که به صورت مستقیم نمی توان آن را سنجش نمود )
  4. نقش متغیر های پنهان را در مدل پیش‌بین، می توان بررسی نمود
مدل سازی معادلات ساختاری 11

برای اجرای این عمل در نرم افزار لیزرل باید داده ها را در نرم افزار تعریف نمایید و سپس  LISREL project را انتخاب کنید و Path Diagram را بزنید. البته می توانید گزینه LISREL project را نیز انتخاب کنید.سپس باید اسم پروژه را وارد کنید و آن را ذخیره کنید.

مدل سازی معادلات ساختاری 15

سپس باید متغیرهای آشکار و پنهان خود را تعریف کنید. بر روی گزینه Add/Read/variable در زیر بخش Observed variables بزنید، تا متغیرهای آشکار را تعریف کنید. در کادر باز شده باید فایل داده ها را فراخوانی کنید تا متغیرها به لیست متغیرهای آشکار اضافه شود. در گام بعدی باید به تعریف سازه ها یا متغیرهای پنهان بپردازید. برای این کار باید از بخش Latent variables گزینه را Add/Read/variable را بزنید.

در مرحله بعدی باید تعداد نمونه تحقیق خود را وارد کنید و سپس باید روی گزینه next بزنید.

مدل سازی معادلات ساختاری 16
مدل سازی معادلات ساختاری 17

سپس باید مشخص کنید که سوالات متغیرهای مکنون و آشکار و مستقل و وابسته کدام هستند. در مرحله اول باید سوالات متغیر مکنون برون زا یا همان مستقل را به عنوان x و سوالات متغیر دورن زا یا وابسته را به عنوان y تعریف نمایید. همین کار را برای متغیرهای مکنون و آشکار نیز انجام دهید و در پایان مدل را اجرا نمایید.

آموزش تحلیل مسیر در نرم افزار لیزرل

مدل سازی معادلات ساختاری با نرم افزار لیزرل 5

روش تحلیل مسیر از الگوی رگرسیون چند متغیره برای تحلیل داده ها استفاده می کند و به جای استفاده از ضرایب وزنی هر گویه، میانگین وزنی گویه ها را محاسبه می کند و به جای متغیر پنهان در مدل قرار می گیرد.  برای اجرای این روش آماری باید داده ها را وارد نرم افزار spss نمایید و متغیرهای خود را تعریف کنید. در مرحله بعدی وارد نرم افزار لیزرل شوید و یک پروژه جدید تعریف نمایید.

در گام بعدی گزینه Path Diagram را انتخاب نمایید.سپس باید متغیرهای آشکار خود را تعریف نمایید.

صفر تا صد تحلیل مسیر با نرم افزار لیزرل

قسمت متغیر مکنون را خالی بگذارید و گزینه next را بزنید.

تحلیل مسیر در لیزرل 3

تعداد نمونه را وارد کنید. سپس باید از بخش matrix to be analyzed گزینه correlation را انتخاب نمایید. در پایان روی ok بزنید.

تحلیل مسیر در لیزرل 4

در گام بعدی باید مدل خود را ترسیم کنید و آن ها را با فلش به هم وصل نمایید.

تحلیل مسیر در لیزرل 10

در نهایت بعد از وصل شدن متغیرها باید گزینه Run LISREL را بزنید.

تحلیل مسیر در لیزرل 5

آموزش شاخص های برازش و اصلاح مدل در لیزرل

در ادامه آموزش لیزرل باید اشاره کرد، شاخص های برازش مدل اهمیت بسیار بالایی در استفاده از نرم افزار لیزرل دارد. سوال این است که داده های گردآوری شده تا چه حد حمایت کننده مدلی است که به لحاظ نظری تدوین شده است؟

انواع شاخص های برازش مدل

  • شاخص های برازش مطلق
  • شاخص های برازش تطبیقی
  • شاخص های برازش مقتصد

برگرفته از: کیارا آکادمی 

برای مشاهده لیست همه ی  پرسشنامه های استاندارد لطفا همین جا روی پرسشنامه استاندارد  کلیک فرمایید.

تحلیل داده های آماری برای پایان نامه و مقاله نویسی ،تحلیل داده های آماری شما با نرم افزارهای کمی و کیفی ،مناسب ترین قیمت و کیفیت عالی انجام می گیرد.نرم افزار های کمی: SPSS- PLS – Amosنرم افزار کیفی: Maxqudaتعیین حجم نمونه با:Spss samplepower

روش های تماس:Mobile :  09143444846  واتساپ – تلگرامکانال تلگرام سایت: برای عضویت در کانال تلگرام سایت اینجا کلیک کنید(البته قبلش فیلتر شکن روشن شود!!) مطالب جالب علمی و آموزشی در این کانال درج می گردد.

تحلیل داده های کیفی با نرم افزار مکس کیو دی ای (Maxqda)

نرم افزار مکس کیو دی ای (Maxqda) نرم افزار حرفه ای برای انجام تحلیل داده های کیفی و روش های ترکیبی و تحلیل آمیخته است. نرم افزار Maxqda برای اولین بار در سال 1989 منتشر شده است و با روشی قدرتمند، ابتکاری و آسان دارای سابقه ای طولانی در کمک به محققین برای انجام تحلیل پروژه های تحقیقاتی موفق می باشد. یادگیری و انجام تحلیل با Maxqda برای پژوهشگران بسیار اهمیت دارد چراکه امروزه با توجه به اینکه امروزه اساتید دانشگاه ها و مراکز پژوهشی و صنعتی به دنبال انجام پژوهش های کیفی، پژوهش های ترکیبی و آمیخته mixed methods هستند.

این نرم افزار قابلیت های تحلیل کمی و آزمونهای آماری (Maxqda stat)، وارد نمودن داده ها از طریق وب، درخت واره واژگانی در maxqda، تجزیه و تحلیل شباهت similarity analysis برای تحلیل فصل چهارم پایان نامه های کارشناسی ارشد و دکتری و همچنین مقالات رشته های مدیریت بیمه، مدیریت آموزشی، مدیریت صنعتی، مدیریت استراتژیک، مدیریت بازرگانی، مدیریت مالی، مدیریت سلامت، مدیریت دولتی، مدیریت منابع انسانی، مدیریت بازاریابی، مدیریت ارشد کسب و کار MBA، مدیریت عالی کسب و کار DBA، مدیریت کارآفرینی، مدیریت اجرایی، مدیریت رفتار سازمانی ، برنامه ریزی آموزشی، علوم اجتماعی، کتابداری، آموزش زبان، روانشناسی عمومی، روانشناسی، روانشناسی صنعتی و سازمانی، روانشناسی بالینی، روانشناسی تربیتی، مشاوره تحصیلی، مشاوره خانواده، مشاوره شغلی، پژوهشگری اجتماعی، علوم تربیتی، کشاورزی، پرستاری محبوبیت بسیاری دارد.

نرم افزار maxqda برای انجام روش های تحقیق کیفی مانند روش گراندد تئوری با استفاده از maxqda، انجام روش نظریه داده بنیاد با مکس کیو دی ای maxqda، انجام تحلیل محتوا با maxqda و همچنین روش های آمیخته به همراه رویکردهای کمی مانند ترکیب تحلیل کیفی maxqda با مدل معادلات ساختاری، ترکیب maxqda با روش های تصمیم گیری چندمعیاره mcdm، ترکیب maxqda با مدلسازی ساختاری تفسیری ISM بسیار گارگشا است. نرم افزار مکس کیو دی ای maxqda برای تحلیل اسناد و documents که به صورت متنی هستند، فایل word، فایل های کتاب، فایل های pdf، فایل های اکسل excel، جداول، عکس ها، ویدئو و تحلیل توییت های توییتر twitter، تحلیل voice ها وصدا ها و غیره که با فرمت های doc، docx، xls، xlsx، txt، pdf، mp3، mp4، jpeg و غیره هستند بکار می رود.

خدمات سایت rava20.ir برای تحلیل داده با نرم افزار مکس کیو دی ای Maxqda

پیاده سازی مصاحبه های کیفی
پیاده سازی مصاحبه ها به صورت متن باز در نرم افزار
كدگذاري متون، تصاویر، سخن رانیها و مصاحبه با استفاده از نرم افزار Maxqda
کدگذاری داده ها با نرم افزار Maxqda برای تحلیل داده ها
کدگذاری خودکار با نرم افزار Maxqda برای تحلیل داده ها
کدگذاری اولیه متن با نرم افزار Maxqda
کدگذاری ثانویه متن با نرم افزار Maxqda
مقوله بندی کلی و تحلیل نتایج بدست آمده از کدگذاری با maxqda
روشهای ترکیبی با نرم افزار Maxqda
مدل بندی داده ها با نرم افزار Maxqda
تحلیل فایلهای صوتی و تصویری با نرم افزار Maxqda
یادداشت گذاری با نرم افزار Maxqda
گزارش یافته های نرم افزار Maxqda برای تحلیل داده های پایان نامه
مدیریت یادداشت ها با نرم افزار maxqda
تبدیل یادداشت های تحلیلی به سند و تحلیل آن با نرم افزار maxqda
فعال سازی اسناد و کدها در نرم افزار maxqda
انجام پایایی کدگذاری در نرم افزار maxqda
انجام تحلیل فیلم با نرم افزار maxqda
انجام تحلیل عکس با نرم افزار maxqda
ترسیم نقشه مکس (MAX MAP) در نرم افزار maxqda
گزارش گیری از تحلیل های کیفی با نرم افزار maxqda

انجام تحلیل پروژه های آماری با نرم افزارهای مختلف کمی . کیفی انجاک می گیرد. برای توضیحات بیشتر کلیک کنید.

تحلیل داده های آماری
تحلیل های کمی با نرم افزار های : SPSS – Amos – Pls تحلیل های کیفی با نرم افزار های : Maxqda – NVivo

داده کاوی (Data mining) چیست؟

 داده کاوی (Data mining) چیست؟ هر آنچه باید در مورد این فناوری بدانید
داده کاوی

داده کاوی (Data mining) چیست؟ هر آنچه باید در مورد این فناوری بدانید

بسیاری از کسب ‌و‌ کارها و سازمان‌ها دارای اطلاعات خام فراوانی هستند که به کمک داده کاوی می‌توانند به اطلاعات نهان، الگوها و روابط مختلف نهفته در داده‌‏ها پی ببرند و به کمک آن‌ها، استراتژی‌های مختلفی اتخاذ و تصمیمات سنجیده‌تری بگیرند.

هوش مصنوعی با استفاده از سرویس‌‏های داده کاوی علاوه بر خوشه‏‌بندی و دسته‏‌بندی داده‌‏ها به مسائلی از قبیل پیش‌‏بینی، آنالیز رفتار افراد و تشخیص ناهنجاری‏‌ها می‌‏پردازد. در ادامه این مقاله به بررسی کامل علم داده کاوی پرداخته شده‌است.

داده کاوی چیست؟

داده کاوی فرآیند جستجو در مجموعه‌ای بزرگ از داده‌ها برای کشف الگوها و روندهایی است که با استفاده از تکنیک‌های تجزیه‌وتحلیل ساده یافت نمی‌شوند.

IBM در توضیح داده کاوی می‌گوید این علم نه‌تنها برای یافتن الگوهای پنهان از داده‌ها مورد استفاده قرار می‌گیرد بلکه می‌توان از آن برای کشف دانش نهفته در مجموعه داده‌های بزرگ، ایجاد مدل‌هایی که ویژگی‌های مربوط به داده‌ها را توصیف می‌کنند و نیز پیش‌بینی بر اساس داده‌ها بهره گرفت.

همچنین داده کاوی به عنوان کشف دانش در داده (KDD) نیز شناخته می‌شود. با توجه به تکامل فناوری انبار داده‌ها و رشد داده‌های بزرگ، استفاده از تکنیک‌های داده کاوی در چند دهه گذشته به سرعت شتاب گرفته است و با تبدیل داده‌های خام به دانش مفید، تصمیمات دقیق‌تر و بهتری گرفته می‌شود.

این نکته نیز قابل ذکر است که این فناوری به طور مداوم برای مدیریت داده‌ها در مقیاس بزرگ تکامل یافته و رشد می‌کند و مهندسین داده کاوی در تلاش برای حل چالش‌های پیش روی خود هستند.

داده کاوی شاخه‌ای از علم آمار است که از الگوریتم‌های پیچیده‌ای استفاده می‌کند تا در نهایت بتوان برای کسب‌و‌کارها جهت جمع‌آوری اطلاعات خاص از حجم زیاد داده‌ها و یافتن راه‌حل برای مشکلات تجاری آن‌ها استفاده کرد. داده کاوی انواع مختلفی دارد که از جمله آن‌ها می‌توان داده کاوی تصویری، متن کاوی، استخراج اطلاعات از رسانه‌های اجتماعی، وب کاوی، و داده کاوی صوتی و تصویری را نام برد.

ادامه‌ی خواندن→

بهترین ابزار داده کاوی در سال 2021 (Data Mining Tools)

بهترین ابزار داده کاوی در سال 2021 (Data Mining Tools)

با بهترین ابزار داده کاوی در سال 2021 آشنا بشوید - داده کاوی ویستا
بهترین ابزار داده کاوی در سال 2021 (Data Mining Tools)

بهترین ابزار داده کاوی در سال 2021

داده کاوی به دنبال پیدا کردن الگوهای پنهان در داده ها  می باشد.

داده کاوی تکنیکی است که به شما کمک می کند روابط نامشخص / کشف نشده را در میان داده های کشف  می کند.

در این مقاله ، ابزارهای مفیدی زیادی برای داده کاوی در دسترس است.

در زیر لیستی از نرم افزار داده کاوی با ویژگی های محبوب و جدیدترین لینک های دانلود آورده شده است.

این لیست مقایسه شامل متن باز و همچنین ابزارهای تجاری است.

ادامه‌ی خواندن→

حداقل مربعات جزئی آمیخته متناهی

حداقل مربعات جزئی آمیخته متناهی

حداقل مربعات جزئی آمیخته متناهی FIMIX-PLS

حداقل مربعات جزئی آمیخته متناهی FIMIX-PLS

منبع: روش حداقل مربعات جزئی آمیخته متناهی نوشته آرش حبیبی

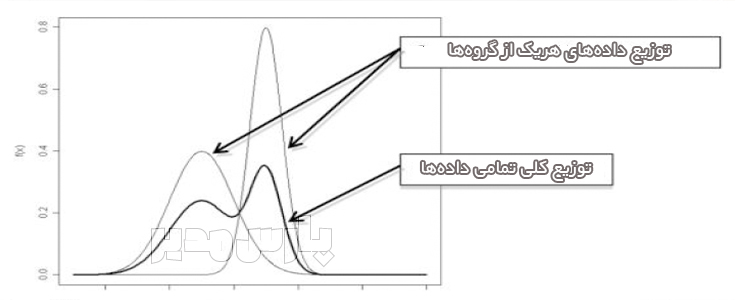
روش Finite mixture partial least squares یا FIMIX-PLS در کانون تحلیل آماری پارس‌مدیر با عنوان حداقل مربعات جزئی آمیخته متناهی ترجمه شده است. روش FIMIX-PLS یکی از قابلیت‌هایی است که به روش حداقل مربعات جزئی اضافه شده است. جوزف هیر و همکارانش (۲۰۱۵) در دو مقاله مستقل این روش را معرفی کرده‌اند. این روش کارایی مشابه با روش‌های داده‌کاوی مانند الگوریتم ژنتیک دارد و برای خوشه‌بندی واحدهای مختلف نمونه مناسب است. درواقع FIMIX-PLS براساس مفهوم ناهگمنی داده‌ها بنا شده است.

با استفاده از روش حداقل مربعات جزئی آمیخته متناهی می‌توان خوشه‌های مختلفی از نمونه را شناسایی کرد. این روش برای بخش‌بندی مشتریان در بازاریابی بسیار مناسب است. بویژه آنکه روش FIMIX-PLS مبتنی بر مباحث حداقل مربعات جزئی است و با حجم اندک نمونه نیز به خوبی قابل اجرا می‌باشد. این روش بویژه با بحث تحلیل چند گروهی  و متغیر تعدیل کننده در ارتباط است.

مدلسازی ناهمگنی مشاهده نشده

آذر به نقل از هیر در کتاب حداقل مربعات جزئی مفهوم مدلسازی ناهمگنی مشاهده نشده را تشریح کرده است. از آنجا که ناهمگنی اغلب در مطالعات تجربی وجود دارد پژوهشگران باید منابع بالقوه ناهنگی را با تشکیل گروه‌هایی از داده‌ها براساس خصیصه‌های قابل مشاهده مدنظر قرار دهند. برای نمونه استفاده از متغیرهای جمعیت‌شناختی مانند سن، جنسیت و تحصیلات می‌تواند مورد استفاده قرار گیرد. وقتی ساختار داده‌های ناهمگن را بتوان به خصیصه‌های قابل مشاهده برگشت داد، از این وضعیت به عنوان ناهمگنی مشاهده شده نام برده می‌شود 

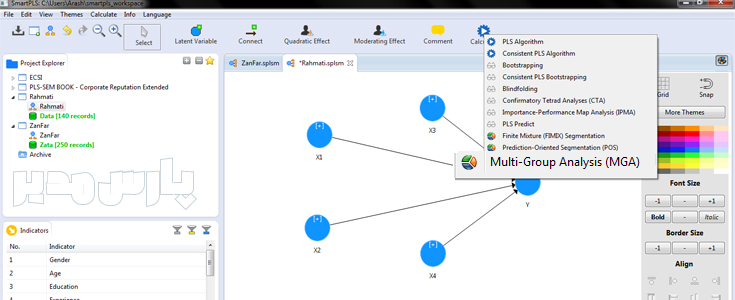
برای تحلیل حداقل مربعات جزئی آمیخته متناهی FIMIX-PLS می‌توانید هم از نرم افزار Smart PLS 3 وهم از  .نرم افزار Smart PLS 2 استفاده کنید. برای این منظور یکی از دو نسخه این نرم افزار را اجرا کنید و از منوی Calculate دستور Finite mixture (FIMIX-PLS) segmentation را انتخاب کنید. می‌توانید به عنوان پیش‌فرض تعیین کند داده‌ها به چند گروه تقسیم شود.

منابع ناهمگنی در داده‌ها هرگز به صورت شناخته شده نیستند. در نتیجه موقعیتی بوجود می‌اید که در آن تفاوت‌های مرتبط با ناهمگنی مشاهده‌نشده مدل مسیری PLS را از برآورد دقیق باز می‌دارد. اگر ناهمگنی مشاهده نشده باعث مشکلات برآورد شود باید از تکنیک‌های مکل برای بخش‌بندی مبتنی بر پاسخ استفاده کرد. روش حداقل مربعات جزئی آمیخته متناهی یکی از همین تکنیک‌ها است.

نحوه تحلیل حداقل مربعات جزئی آمیخته متناهی

برگرفته از پارس مدیر – نویسنده آرش حبیبی

دانلود کتاب آموزش تصویری تعیین حجم نمونه با Spss sample power نرم افزار

تحلیل چند گروهی PLS-MGA

تحلیل چند گروهی PLS-MGA

تحلیل چند گروهی PLS-MGA

آموزش تحلیل چند گروهی PLS-MGA

منبع: آموزش تحلیل چند گروهی PLS-MGA نوشته آرش حبیبی نشر الکترونیک پارس مدیر

تحلیل چند گروهی Multigroup Analysis (MGA) یکی از موضوعات کاربردی در زمینه حداقل مربعات جزئی است. برای پی بردن به اینکه آیا تفاوت معناداری میان ضرایب مسیر میان متغیرها در گروه‌های مختلف وجود دارد، باید تحلیل چند گروهی PLS-MGA انجام شود. روش PLS- MGA به مجموعه‌ای از تکنیک‌های مختلف برمی‌گردد که برای مقایسه برآوردهای مدل حداقل مربعات جزئی در میان گروه‌های مختلف داده‌ای توسعه داده شده‌اند. معمولاً PLS- MGA برای جستجوی تفاوت‌های میان ضرایب مسیر در مدل ساختاری استفاده می‌شود. با این وجود می‌توان سایر پارامتراهی آنها برای مثال بارها یا وزن‌ها را باهم مقایسه کرد.

روش PLS- MGA یک رشته مطالعاتی جدید است و اخیراً چندین رویکرد برای آن پیشنهاد شده است. از این روش برای مقایسه داده‌های دو یا چندگروه استفاده می‌شود. برای نمونه اگر بخواهیم دیدگاه دو گروه مختلف را بررسی کنیم روش PLS-MGA هم ارز روش تی-مستقل خواهد بود. فرض کنید بخواهید رابطه متغیرها را براساس دیدگاه زنان و مردان به تفکیک بررسی کنید. همچنین اگر با بیش از دو گروه سروکار داشته باشید این روش با تحلیل واریانس قابل مقایسه خواهد بود.

علت استفاده از روش تحلیل چند گروهی

در یک مطالعه رابطه رضایت و اعتماد مشتریان به سایت پارس مدیر بررسی شده است. میزان تاثیر رضایت بر وفاداری با استفاده از روش حداقل مربعات جزئی ۰/۶۴ بدست آمده است. اکنون این سوال مطرح می‌شود که آیا پژوهشگران مورد بررسی همگن هستند؟ یعنی دیدگاه همه افراد نمونه بصورت یکپارچه و قابل تعمیم می‌باشد؟ در این مثال ممکن است دیدگاه دانشجویان با پژوهشگران مستقل متفاوت باشد. آنچه رضایت دانشجویان را از یک سایت مدیریتی فراهم می‌کند با پژوهشگران مستقل تفاوت دارد.

از آنجا که ناهمگنی در بیشتر مطالعات تجربی وجود دارد، پژوهشگران گاهی باید منابع بالقوه ناهنگی را با تشکیل گروه‌هایی براساس خصیصه‌های قابل مشاهده بررسی نمایند. در بیشتر موارد از متغیرهای جمعیت شناختی مانند جنسیت، سن و تحصیلات برای گروه‌بندی افراد نمونه استفاده می‌شود. گاهی نیز از سازه‌های پنهان برای گروه‌بندی افراد نمونه استفاده می‌شود. در زمینه ناهمگنی داده‌ها در بحث حداقل مربعات جزئی آمیخته متناهی FIMIX-PLS تشریح شده است.

روش محاسبه تحلیل چند گروهی

برای تحلیل چند گروهی PLS-MGA می‌توانید از نرم افزار Smart PLS 3 استفاده کنید. در نرم افزار Smart PLS 2 امکان محاسبه مستقیم تحلیل چندگروهی وجود ندارد اما با این نرم افزار نیز می‌توان تحلیل را انجام داد.

اگر بررسی دیدگاه دو گروه را در نظر گرفته اید ابتدا باید مشخص شود که واریانس دیدگاه دو گروه باهم برابر است یا خیر. همچنین ملاحظات حجم نمونه نیز باید در نظر گرفته شود. بطوریکه در هر گروه حداقل ۱۰ برابر تعداد روابط میان متغیرهای پنهان نمونه وجود داشته باشد. همچنین به سه فایل داده نیاز دارید: فایل داده کامل، فایل داده گروه اول، فایل داده گروه دوم. براساس آموزش نحوه وارد کرده داده‌ها به PLS هر سه فایل داده را فراخوانی کنید. در نرم افزار نسخه دو باید سه بار مدل را اجرا کنید اما در نسخه ۳ کافی است تا از منوی Calculate دستور Multigroup Analysis (MGA)  را اجرا کنید.

برگرفته از پارس مدیر – نویسنده آرش حبیبی

دانلود کتاب آموزش تصویری تعیین حجم نمونه با Spss sample power نرم افزار

مدل بازگشتی

مدل بازگشتی

مدل بازگشتی

مدل بازگشتی چیست؟

مدل بازگشتی Recursive model شکل ویژه‌ای از یک مدل معادلات ساختاری است که در آن متغیرهای برون‌زا به صورت همزمان تعیین و تبیین می‌شوند. به بیان دیگر ممکن است در مدل ساختاری متغیرهایی باشد که همزمان با تغییر در متغیر وابسته به صورت غیرمستقیم بر خودشان نیز اثر بگذارند. به لحاظ محاسباتی مدل‌های بازگشتی به سادگی مدل‌های غیر بازگشتی نیستند. در بیشتر موارد این امکان وجود دارد که پژوهشگر با مشکل نامشخص بودن برخی از پارامترها مواجه شود، بویژه اگر مدل از پیچیدگی برخوردار باشد. با این وجود در بسیاری مسائل مدیریت و علوم اجتماعی ماهیت مساله به گونه‌ای است که حالت بازگشتی دارد. دشواری محاسبات و کاربردی بودن این نوع الگو هر پژوهشگری را دچار تعارض می‌کند.

در واقع در مدل‌های ساختاری گاهی ما شاهد اثرات متقابل یا دو سویه هستیم و پژوهشگران نشان داده اند که چنین مفروضه هایی به لحاظ روش پژوهش امکان پذیر است. اما باید دید از لحاظ نرم افزاری دوستانی که در کلاس‌های ایموس آکادمی شرکت نموده اند در مواجهه با چنین روابط بازگشتی چگونه باید عمل کنند. با توجه به اینکه اثر یک متغیر بر خودش تنها با استفاده از داده‌های ناشی از مطالعات طولی قابل بررسی است، استفاده از داده‌های مقطعی برای چنین اثراتی نیز به طور ضمنی به معنای آن است که یک وضعیت پویا را به یک وضعیت ایستا تقلیل داده ایم. با این حال برخی پژوهشگران نشان داده اند که چگونه با برقرار بودن برخی مفروضه ها، چنین امری امکان پذیر است.

تعریف مدل‌های بازگشتی

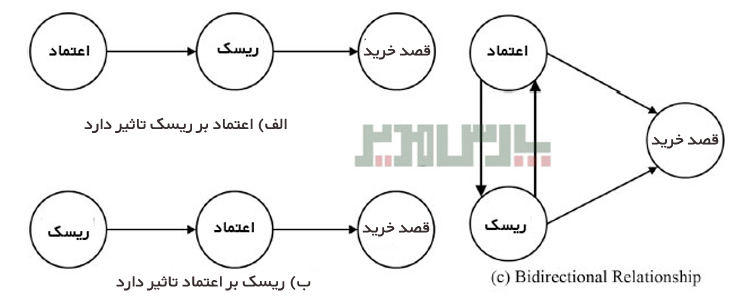
در تدوین مدل‌های ساختاری گاهی وضعیتی پیش می‌آید که در آن پژوهشگر ممکن است بین دو متغیر اثر متقابل یا دو سویه تعریف کند. به این معنی که مایل نیست ارتباط بین دو متغیر را به عنوان یک همبستگی صرف تعریف کند؛ به عبارت دیگر اثر گذاری به صورت یک سویه و تنها از یک متغیر مستقل به سمت متغیر وابسته نیست. مدل‌های بازگشتی را به عنوان مدل هایی تعریف می‌کنند که در آن حلقه ی بازخورد یا پس خورانی (Feedback Loop) وجود دارد. رابطه دو طرفه یا بازگشتی به این معناست که یک متغیر به طور غیرمستقیم برخود اثر می‌گذارد.

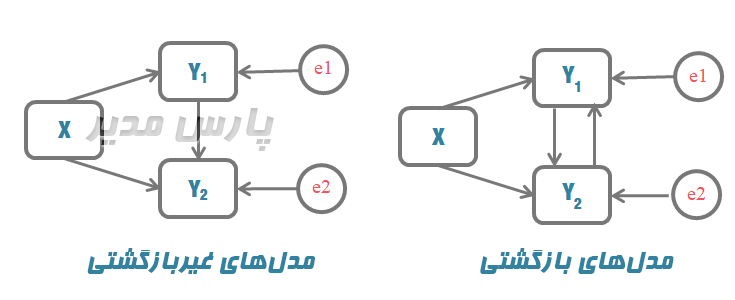
در ترسیم این نوع مدل‌ها در ایموس باید دو پیکان رسم نمایند. یعنی یک پیکان یک طرفه از سمت متغیر اول به دوم و بعد یک پیکان یک طرفه هم از سمت متغیر دوم به اول. خوب تا اینجای کار بدون ایراد جلو می‌رود اما نکته مهم اینجاست که در مدل‌های بازگشتی با این تاثیر‌های متقابل، به طور ضمنی خطاهای هر متغیر(هر متغیر وابسته یک خطای باقی مانده دارد. پس در اینگونه مدل ها، هر دو متغیر دارای خطا هستند زیرا هر دو هم زمان هم مستقل و هم وابسته هستند) با یکدیگر همبسته هستند. چرا که وقتی دو متغیر بر هم تاثیر متقابل گذارند بدیهی است که متغیر‌های باقی مانده ی در نظر گرفته نشده در مدل، که در کلاس‌ها خطای باقی مانده خوانده می‌شد باید با هم همبستگی داشته باشند. بنابراین مدل را بدرستی ترسیم و اجرا می‌کنیم.

مثال کاربردی

به عنوان مثال با توجه به دو متغیر اعتماد و ریسک ادراک‌شده می‌توان مدلی را تعریف کرد که در آن از یک سو ریسک ادراک‌شده تابعی از اعتماد مشتریان است واز طرف دیگر اعتماد مشتریان نیز تابعی از ریسک ادراک‌شده تعریف می‌شود.

رابطه اعتماد و ریسک ادراک‌شده

رابطه بازگشتی و غیربازگشتی اعتماد و ریسک ادراک‌شده

به عبارت دیگر در طول زمان نه تنها بالا رفتن اعتماد در میان مشتریان می‌تواند به کاهش ریسک منجر شود، از طرف دیگر بالا رفتن ریسک بین گروهی از افراد خود می‌تواند به کاهش اعتماد در میان آنان منجر شود. در این وضعیت دو پارامتر بتا به عنوان پارامتر آزاد تعریف شده و از درجات آزادی مدل کاسته خواهد شد. چنین وضعیتی را با نام اثر بر خود (Effect on Self) نامگذاری کرده است. اغلب بیش از یک شیوه برای روابط بازخوردی در مدل وجود دارد. ساده ترین شکل آن مدلی است که در آن دو متغیر بدون واسطه بر خودشان اثر می‌گذارند.

تکته نهایی اینکه کلاین معتقد است اتفاقا مدل‌های بازگشتی به جهان واقعی نزدیک تر هستند چرا که بسیاری از متغیر‌های جهان بر یکدیگر تاثیر متقابل و دو سویه دارند اما در نهایت به دلیل اینکه اطلاعات و مشاهدات چنین مدل هایی را باید از مطالعات پیمایشی طولی بدست آورد و همچنین بدلیل اینکه ممکن است تعداد مجهولات معادله ساختاری از تعداد معادلات آن بیشتر باشد و این باعث غیر مشخص شدن پارامتر‌های مدل شود پژوهشگران تمایلی به استفاده از چنین مدل هایی را ندارند.

حلقه بازخورد  در مدل بازگشتی

در حالتی کمی پیچیده تر اثر متقابل دو متغیر بر یکدیگر با یک واسطه و همچنین اثر یک متغیر بر خودش با دو واسطه شکل می‌گیرد: وجود حلقه بازخوردی به طور ضمنی به معنای آن است که متغیرهای خطای درگیر در مدل با یکدیگر همبسته اند. به بیان دیگر اگر دو متغیر با یکدیگر تعامل دارند بنابراین منطقی است که عوامل تأثیر گذار بر آن‌ها که در متغیرهای گنجانده شده در مدل ساختاری به عنوان متغیر بیرونی یا درونی آورده نشده اند (یا همان متغیرهای خطا) با یکدیگر همبسته باشند.

به منظور برآورد پارامترهای مدل نوعی از رویکرد حداقل مربعات به نام حداقل مربعات دو مرحله‌ای وجود دارد که به منظور برآورد مدل‌های بازگشتی به کار برده می‌شود. البته برآورد پارامترها در این مدل‌ها با استفاده از روش درستنمایی ماکزیمم نیز امکان پذیر است.

با توجه به اینکه طرح‌های مقطعی تنها یک تصویر منفرد از یک فرآیند پویای در حال حرکت هستند، بنابراین برآورد اثرات دو سویه با داده‌های مقطعی نیازمند برقرار بودن فرضیه تعادل است. فرضیه تعادل به این معنا است که برآورد پارامترها وابسته به زمان خاص گردآوری داده‌ها نیست.  به منظور بررسی این فرضیه وقتی که یک مدل بازگشتی تحلیل و برآورد می‌شود شاخصی به نام شاخص ثبات نیز در خروجی Amos ارائه می‌گردد. به لحاظ کاربردی تفسیر استاندارد شاخص ثبات چنین است که اگر مقدار آن کمتر از ۱ باشد حاکی از برقراری فرضیه تعادل است در حالیکه مقادیر بالاتر از ۱ فقدان برقراری فرضیه تعادل را تأیید می‌کنند.

نتیجه‌گیری

در واقع مدل‌های بازگشتی که بیانگر اثر یک متغیر بر خودش می‌باشد مناسب داده‌های طولی و طرح‌های پانل است که در آن‌ها داده‌ها برای متغیرهای مشابه در دو زمان مختلف گردآوری شده اند، اما با این وجود می‌توان آن‌ها را برای داده‌های مقطعی که در یک زمان جمع آوری شده اند نیز مورد استفاده قرار داد. به عنوان مثال اگر صرفا بر دو متغیر رضایت و اعتماد مشتریان تمرکز کنیم با فرض این که در دو سال متفاوت با ابزارهای یکسان و جامعه آماری یکسان، داده‌های مورد نظر را گردآوری کنیم، مدل مورد نظر ما یک مدل غیر بازگشتی خواهد بود.

بنابراین طرح حلقه‌های بازگشتی ناشی از وجود اثرات متقابل در طول زمان است که امکان آن در یک مدل غیربازگشتی با داده‌های طولی وجود دارد و استفاده از داده‌های غیربازگشتی در واقع برای بررسی آن است. با وجود اهمیت استفاده از مدل‌های بازگشتی در بسیاری از مطالعات اجتماعی، به دلیل مشکلاتی که انجام مطالعات طولی در بر دارد و همچنین به دلیل غیرمشخص شدن برخی از پارامترها در مدل‌های بازگشتی و به تبع آن عدم امکان برآورد پارامترها، بازسازی ماتریس واریانس-کواریانس و محاسبه شاخص‌های برازش مدل، پژوهشگران کمتر تمایل به بهره‌گیری از این نوع مدل‌ها دارند.

برگرفته از پارس مدیر – نویسنده آرش حبیبی

دانلود کتاب آموزش تصویری تعیین حجم نمونه با Spss sample power نرم افزار

نرم افزار G*Power

نرم افزار G*Power

دانلود نرم افزار G*Power

نرم افزار G*Power یک نرم افزار کاربردی و ساده آماری است که برای محاسبه حجم نمونه در مباحث جامعه و نمونه بسیار مناسب است. این نرم افزار رایگان است و بسادگی می‌توان حجم نمونه لازم برای حداقل مربعات جزئی به روش محاسبه حجم نمونه با فرمول کوهن را با آن محاسبه کرد. همچنین حجم نمونه لازم برای انواع تحقیق همبستگی،انواع آزمون میانگین جامعه، حجم نمونه رگرسیون و روش‌های دیگر آماری را محاسبه کرد.

استفاده از ماشین حساب  G*Power

نرم افزار G*Power یک ماشین حساب حرفه‌ای در اختیار کاربران قرار می‌دهد.

از منوی اصلی و بالای صفحه نرم افزار گزینه Calculator را انتخاب کنید.

روش محاسبه حجم نمونه با نرم افزار G*Power

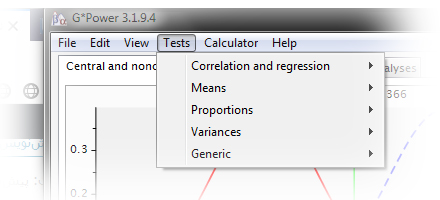
برای محاسبه حجم نمونه با نرم افزار G*Power ابتدا از منوی Tests نوع نمونه خود را انتخاب کنید.

روش‌های همبستگی و رگرسیون در منوی Correlation and Regression قابل دسترسی است.

محاسبه حجم نمونه با نرم افزار G*Power

محاسبه حجم نمونه با نرم افزار G*Power

روش‌های آزمون میانگین جامعه مانند تی-تک‌نمونه و تی-مستقل از قسمت Means قابل دسترسی است.

پس از انتخاب آزمون موردنظر، اندازه اثر و سطح خطا را در صفحه اصلی نرم افزار مشخص کنید.

در نهایت در صفحه اصلی نرم‌افزار روی دکمه Calculate کلیک کنید.

روی دکمه  X-Y Plot for a range of values کلیک کنید.

در نهایت در دیالوگ جدید روی دکمه Draw Plot کلیک کنید.

مشخصات مربوط به حجم نمونه به صورت گرافیکی نیز قابل مشاهده است.

دانلود نرم افزار G*Power

نحوه نصب نرم‌افزار

فایل دانلود شده را از حالت فشرده خارج کنید. این نرم افزار نیاز به نصب دارد. فایل نصی یا setup را اجرا کنید تا عملیات نصب صورت گیرد. پس از آن می‌توانید با کلیک نمودن بر فایل اجرایی برنامه آن را اجرا کنید. فایل تجرایی با لوگوی این نرم افزار نشان داده می‌شود.

همانطور که بسیاری از کاربران آمارافزار اطلاع دارند، در یکی از دوره‌های آموزشی آمارافزار، تحت عنوان «دوره محاسبه حجم نمونه و توان آماری»، که اتفاقاً در گروه دوره‌های پرطرفدار نیز محسوب شده، این نرم افزار و کار عملی با آن، آموزش داده می‌شود.

ضمناً لازم به ذکر است که در کاربردهای عملی نرم افزار G*Powerر برای محاسبه حجم نمونه مطالعات پژوهشی و همچنین مقالات علمی، امکان ارجاع به این نرم افزار وجود دارد. از منظر داوران مقالات علمی و ادیتورهای ژورنالهای معتبر، این نرم افزار قابل قبول  بوده و برای مقاصد عملی می‌تواند جایگزین فرمولهای محاسبه حجم نمونه و حتی نرم افزارهای تجاری قوی شود. نرم افزار بسیار قوی و معتبر NCS-PASS نیز نتایج مشابهی دارد.

برگرفته از پارس مدیر – نویسنده آرش حبیبی

دانلود کتاب آموزش تصویری تعیین حجم نمونه با Spss sample power نرم افزار

تعیین حجم نمونه PLS

تعیین حجم نمونه PLS

تعیین حجم نمونه PLS

تعیین حجم نمونه در حداقل مجذورات جزیی

منبع : تعیین حجم نمونه حداقل مجذورات جزیی نوشته آرش حبیبی

یک دیدگاه اشتباه در مورد تکنیک PLS آن است که تکنیک حداقل مربعات جزیی برای هر حجمی از نمونه قابل استفاده است. حجم نمونه در مدل یابی مسیر PLS می‌تواند تا اندازه قابل ملاحظه‌ای کوچک باشد. برای نمونه متغیرها نسبت به مشاهده‌ها بیشتر بوده و ممکن است مقداری از داده‌ها بطور تصادفی بدست نیامده باشد. به دلیل این ویژگی هاست که پژوهشگران، هنگامی که حجم نمونه نسبتاً پایین است از مدل‌سازی مسیر PLS به جای لیزرل استفاده می‌کنند.

انتخاب حجم نمونه مناسب بیشتر به اندازه روابط یا سطح توان دلخواه وابسته است. پژوهشگر قبل از تصمیم‌گیری برای انتخاب یک نمونه مناسب باید ویژگی‌های توزیعی داده ها، داده‌های حاصل نشده بالقوه، ویژگی‌های سنجش متغیرهای مورد بررسی و مقدار روابط را مورد توجه قرار دهد، یا اطمینان یابد که واقعاً حجم نمونه کافی برای مطالعه پدیده مورد علاقه در دسترس است.

جدول محاسبه حداقل حجم نمونه لازم برای PLS

با وجود اینکه PLS برای نمونه‌های خیلی کوچک و یا موقعی‌که موارد نسبت به متغیرهای نشانگر کمتر باشد قابل استفاده است، اما تکیه بر نمونه‌های کوچک می‌تواند نتایج ضعیفی فراهم کند. نمونه‌های بزرگتر، برآوردهای PLS را قابل اطمینان تر می‌سازد. بنابراین میانگین میزان خطای مطلق در PLS با افزایش حجم نمونه کاهش می‌یابد. حجم نمونه کوچک برای ضرایب مسیر کوچک کافی نیست، در این صورت حجم نمونه برابر با مدل یابی معادلات ساختاری مورد نیاز است.

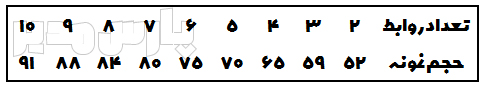
در واقع برخی از متخصصین توصیه می‌کنند استفاده کنندگان PLS از راه برد «قاعده ۱۰» مشابه با مدل یابی مبتنی بر کوواریانس استفاده کنند. حجم نمونه باید ۱۰برابر بیشترین از تعداد مسیرهای بین سازه‌ها (یعنی همان روابط بین متغیرهای پنهان) باشد. این قواعد سرانگشتی معادل این است که گفته شود حداقل حجم نمونه باید ده برابر حداکثر تعداد پیکان‌هایی باشد که به یک متغیر پنهان در مدل مسیری حداقل مربعات جزئی وارد می‌شود. روش‌های سرانگشتی متعدد دیگری نیز برای تعیین حجم نمونه در حداقل مربعات جزئی ارائه شده است. ایراداتی نیز به این روش‌ها وارد شده است.

روش تحلیل توان برای محاسبه حجم نمونه در حداقل مربعات جرئی

در این میان از روش تحلیل توان Power Analysis که توسط جاکوب کوهن (۱۹۹۲) ارائه شده، بیشتر استفاده می‌شود. پژوهشگران معتقدند حجم نمونه مورد نیاز باید بوسیله تحلیل توان براساس قسمتی از مدل با بزرگترین تعداد پیش‌بین‌ها تعیین شود. در تحلیل توان آماری کوهن برای مدل‌های رگرسیون چندگانه (OLS) آمده است که مدل‌های اندازه‌گیری کیفیتی قابل قبول برحسب بارهای بیرونی دارند. بارهای عاملی باید بالاتر از آستانه مشترک ۰/۷ باشند.

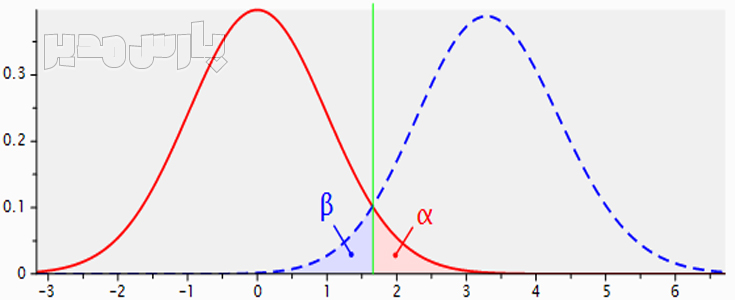
پژوهشگران از برنامه‌هایی مانند نرم افزار G*Power برای اجرای تحلیل توان مختص تنظمیات مدل استفاده می‌کنند. حجم نمونه لازم برای روش حداقل مربعات جزئی در سطح اطمینان ۹۵% با ضریب تشخیص ۲۵% در جدول زیر ارائه شده است. این جدول بیش از همه روش‌های دیگر مورد استفاده پژوهشگران قرار می‌گیرد.

حجم نمونه حداقل مجذورات جزیی

حجم نمونه حداقل مجذورات جزیی

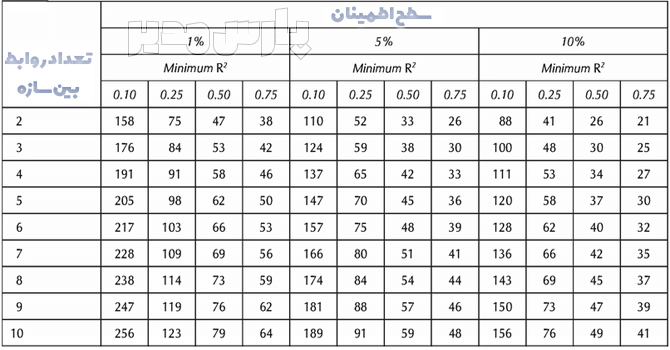
جدول کاملی که کوهن (۱۹۹۲ برای محاسبه حداقل حجم نمونه براساس سطوح خطای مختلف جهت دستیابی به میزان‌های مختلفی از ضریب تشخیص در زیر ارائه شده است. در این جدول حجم نمونه براساس سطح خطای ۱%، ۵% و ۱۰% برای ۲ تا ۱۰ رابطه بین سازه‌ها تعیین شده است. بسته به اینکه پژوهشگر به دنبال چه میزان از ضریب تشخیص باشد می‌توان حجم نمونه را با جدول زیر تعیین کرد.

حداقل حجم نمونه PLS

حداقل حجم نمونه PLS

حداقل حجم نمونه در تکنیک حداقل مجذورات جزیی یا PLS دلخواه نیست. اگرچه با استفاده از تکنیک‌های بوت‌استراپینگ مدل‌های PLS با هر حجمی اجرا می‌شوند اما نتایج و دقت آنها بشدت به حجم نمونه وابسته است. بنابراین در بکارگیری نمونه لازم برای PLS دقت کنید.

Hair Jr, J. F., Hult, G. T. M., Ringle, C., & Sarstedt, M. (2013). A primer on partial least squares structural equation modeling (PLS-SEM). Sage Publications.

Cohen, J. (1992). A power primer. Psychological bulletin, 112(1), 155.

برگرفته از پارس مدیر – نویسنده آرش حبیبی

کتاب آموزش تصویری نمونه گیری با SPSS Sample Power

بلایندفولدینگ

بلایندفولدینگ

بلایندفولدینگ Blindfolding یک تکنیک استفاده مجدد از نمونه است. این تکنیک امکان محاسبه شاخص استون-گیزر Stone-Geisser را فراهم می‌کند. معیار استون- گیزر  یا شاخص Q2 قدرت پیش‌بینی مدل را مشخص می‌سازد.  شاخص استون-گیزر معیاری برای ارزیابی روایی متقاطع در مدل حداقل مجذورات جزیی است. شاخص ضریب تعیین R2 دقت پیش‌بینی را مشخص می‌کند و شاخص Q2 رابطه‌مند بودن پیش‌بینی را تعیین می‌کند. چناچه مقدار شاخص استون-گیزر مثبت باشد روایی پیش‌بینی مورد تایید است.

کاربرد : محاسبه شاخص برای ارزیابی روایی متقاطع Cross-Validity

برگرفته از پارس مدیر – نویسنده آرش حبیبی